Week 04 · Public archive
UFO Archive KR
스캔 문서 1,616쪽을 출처로 되돌아갈 수 있는 한국어 기록물로
FBI Vault에 공개된 UFO 관련 PDF 16개를 한국어 독자가 읽고 검색할 수 있도록 OCR, 원문 대조, 번역 검수, 정적 웹 리더까지 하나의 재현 가능한 파이프라인으로 연결했습니다. 이 프로젝트는 UFO의 진위를 주장하지 않습니다. 공개 기록을 과장 없이 읽기 쉽게 만드는 비공식 아카이브입니다.
- 16
- FBI Vault PDF Part 01–16
- 1,616
- 원문 페이지 출처 매니페스트 기준
- 13,218
- 한국어 번역 단위 공개 검토 데이터셋
Problem
해결하려는 문제
공개되어 있어도 읽을 수 없었습니다.
원본은 저해상도 스캔, 타자기 흔적, 검열 표시와 훼손이 섞인 PDF입니다. 파일을 내려받을 수 있다는 사실과 한국어 독자가 내용을 탐색할 수 있다는 것은 다른 문제였습니다. 일반 검색으로는 문서 안의 사건·날짜·기관을 찾기 어렵고, 자동 OCR만으로는 글자가 틀려도 알아채기 힘듭니다.
번역보다 먼저 원문 신뢰도를 다뤄야 했습니다.
흐릿한 글자를 AI가 그럴듯하게 보완하면 읽기는 쉬워지지만 기록물로서의 가치는 사라집니다. 그래서 번역량을 늘리는 대신, 어떤 문장이 어느 PDF의 몇 쪽과 연결되는지 그리고 이미지에서 실제로 확인되었는지를 먼저 보존했습니다.
Sources
데이터와 출처
서비스 화면의 수치와 결과가 어디에서 왔는지 사용자가 다시 확인할 수 있도록, 원천 데이터와 가공 결과를 분리해서 관리합니다.
FBI Vault · UFO
프로젝트의 유일한 원천 문서 목록입니다. 16개 PDF의 원본 URL, 페이지 수와 SHA-256 해시를 별도 매니페스트에 기록해 로컬 파일과 공개 원문을 대조합니다.
FBI Vault 원문 보기 ↗공개 OCR·한국어 번역 데이터셋
Part와 페이지 단위 OCR 텍스트, 구조화된 라인 데이터, 한국어 번역 단위, 번역에서 제외한 미확정 라인을 분리해 공개합니다. 출처 메타데이터는 CC0, 한국어 번역 export는 CC BY 4.0 정책을 따릅니다.
데이터셋 구조 보기 ↗Build
직접 구현한 기술적 차별점
이미지 증거를 통과해야 번역되는 8단계 파이프라인
Tesseract 베이스라인 → 신뢰도 트리지 → Codex 비주얼 검수 → 400dpi 재처리 → Gemini Vision 후보 → 라인 감사 → Codex 크롭 검수 → 번역 핸드오프로 이어집니다. 모델 출력은 정답이 아니라 후보이며, 페이지 이미지와 일치한 라인만 번역 단계로 승격합니다.
Part·Page·Source line까지 이어지는 역추적
각 번역 단위는 part, page, source line 정보를 유지합니다. 사용자는 한국어 문장을 읽다가 원본 스캔과 출처 메타데이터로 돌아갈 수 있습니다. 웹 리더의 URL도 Part와 페이지를 그대로 반영합니다.
틀린 답 대신 미확정 상태를 보존
이미지에서 확인할 수 없는 문장은 추론으로 채우지 않고 excluded_source_lines.json으로 분리합니다. Part 01 기준으로 이미지와 일치한 1,737줄과 영구 미해결 321줄을 구분해 기록했습니다.
정적 리더와 검색 인덱스
Astro 정적 빌드가 공개 데이터셋만 읽도록 제한했습니다. 원본 PDF, 비공개 OCR 작업 공간, 모델 로그와 환경 변수는 배포에 포함하지 않으며, 검색과 페이지 리더는 서버 비밀값 없이 동작합니다.
How to use
사용 방법
- 01
아카이브에서 문서 Part를 선택합니다.
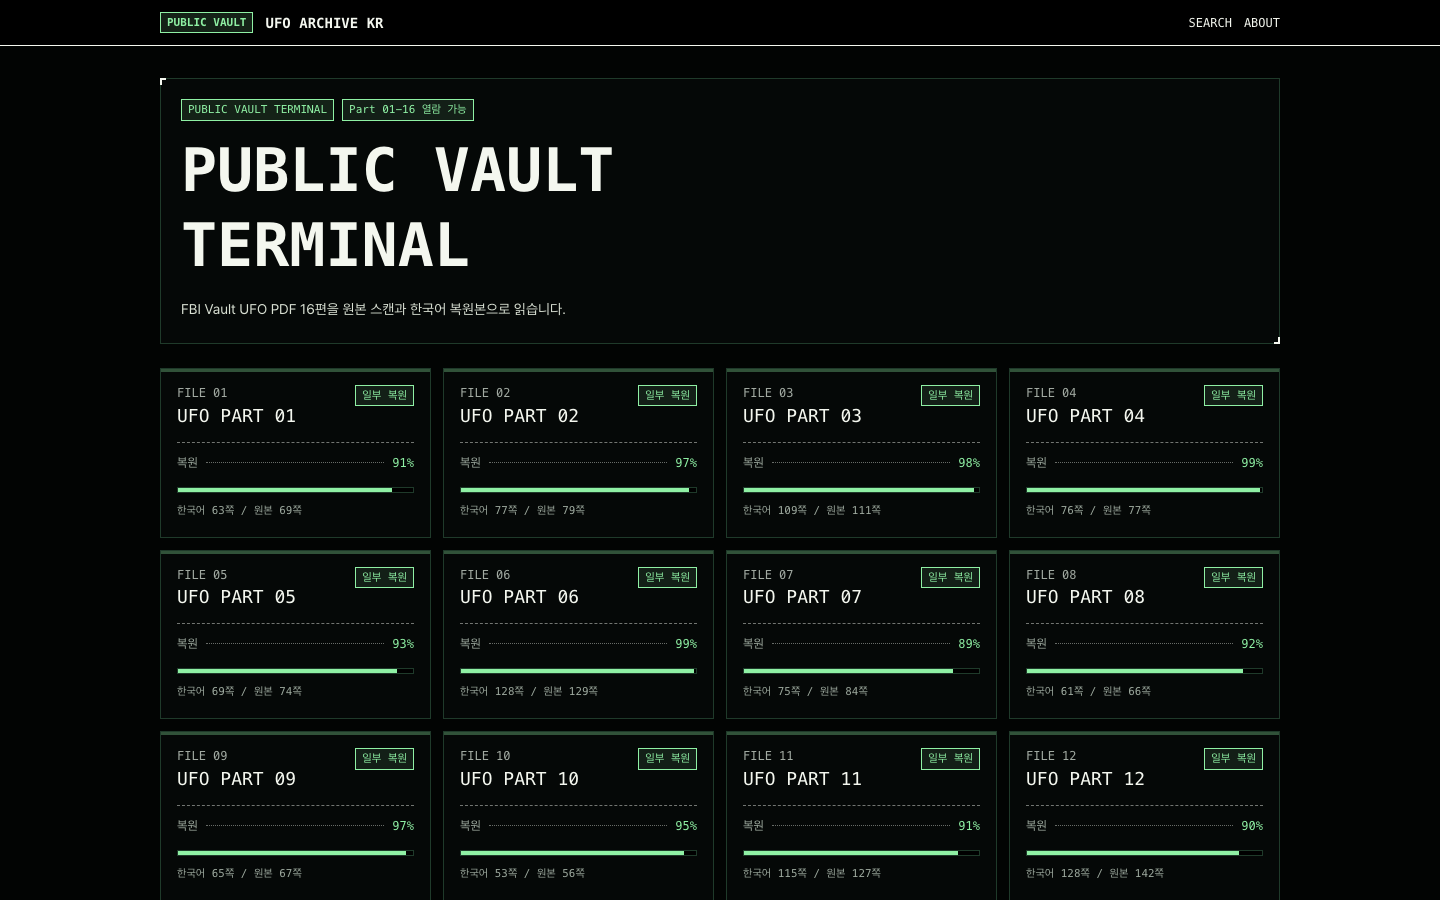
홈 화면에서 16개 파일의 페이지 수와 복원 상태를 비교하고 읽고 싶은 Part로 들어갑니다.
- 02
페이지별 한국어 복원본을 읽습니다.
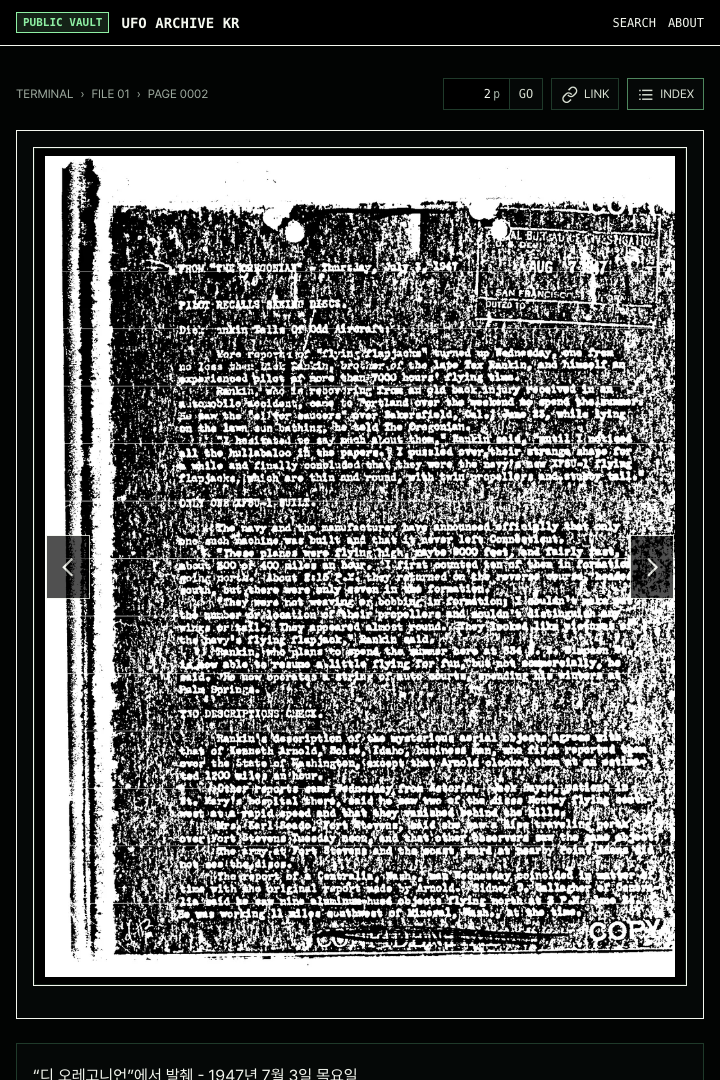
각 페이지에서 원본 스캔, 한국어 텍스트와 출처 메타데이터를 함께 확인할 수 있습니다.
- 03
검색으로 문서 전체를 횡단합니다.
한국어·영문 키워드로 공개 번역 단위를 찾고 검색 결과에서 해당 Part와 페이지로 이동합니다.
- 04
중요한 문장은 FBI Vault 원문과 대조합니다.
리더는 독해 보조 도구입니다. 연구나 재사용이 필요한 문장은 출처 링크와 해시 정보를 이용해 원문을 다시 확인합니다.
Product
실제 화면
Process
제작 과정과 결과
- 01
출처 고정
FBI Vault 목록을 기준으로 16개 PDF의 URL, 페이지 수와 해시를 먼저 고정했습니다. 이후 모든 산출물이 이 매니페스트로 돌아가도록 데이터 계약을 설계했습니다.
- 02
OCR 품질 게이트 설계
단일 OCR 결과를 바로 번역하지 않고 저신뢰 구간을 선별해 고해상도 이미지와 여러 비전 검토 단계를 통과시키는 파이프라인을 만들었습니다.
- 03
16개 Part 공개 export
Part 01–16을 동일한 폴더와 스키마로 export하고, 미확정 라인과 공개 가능한 번역 단위를 분리했습니다.
- 04
웹 리더 배포
공개 데이터셋만 읽는 Astro 리더를 제작해 ufo.n2f.site에 배포했습니다. 아카이브·페이지·검색·소개 화면을 정적 경로로 제공합니다.
Result
1,616쪽을 하나의 탐색 가능한 기록물로 전환
16개 PDF와 13,218개 한국어 번역 단위가 동일한 출처 규칙으로 연결됐습니다. 단순 번역문 묶음이 아니라 페이지로 되돌아갈 수 있는 공개 데이터셋이 되었습니다.
Result
과장을 줄이는 제품 원칙을 코드와 데이터에 반영
원문에 없는 사실을 추가하지 않고, 확인하지 못한 텍스트를 미확정 상태로 남기며, FBI·미국 정부와 무관한 비공식 프로젝트임을 공개 범위와 UI에 명시했습니다.
/ Live product
설명보다 직접 사용해 보세요.
이 페이지는 제작 배경과 데이터 출처를 설명합니다. 실제 기능과 최신 데이터는 라이브 서비스에서 확인할 수 있습니다.
ufo.n2f.site서비스 열기 ↗